(04) Sistemi / Caso di studio
aria-er
I numeri coincidono con quelli di ARPAE.
aria-er è una piattaforma dati sulla qualità dell'aria in Emilia-Romagna: open data ARPAE e meteo di Open-Meteo, dall'ingestion alla dashboard. Questa pagina mostra come è fatta e come sono stati verificati i risultati.
- Inizio
- Settembre 2026
- Versione
- 1.2.0, ottobre 2026
- Team
- Uno sviluppatore
- Codice
- Pubblico, MIT
Rust · dbt · DuckDB · BigQuery · Dagster · Streamlit · Terraform · Docker
Il problema
ARPAE pubblica le misure della qualità dell'aria dell'Emilia-Romagna come open data, ma non in una forma a cui si possano fare domande: valori orari e giornalieri sparsi su più servizi, provvisori per settimane e poi corretti, codici delle stazioni che cambiano da un file all'altro.
Le domande sono semplici: quante volte ogni stazione ha superato i limiti di legge, se l'aria sta migliorando, quanto aggiunge il traffico all'inquinamento di fondo, come vento e pioggia muovono il PM10. Rispondere con numeri di cui fidarsi è il lavoro.
Vincoli
- I valori recenti vengono corretti per settimane: ogni esecuzione rielabora una finestra di 30 giorni e aggiorna per stazione, inquinante e ora. Rieseguire la stessa finestra produce gli stessi file.
- I timestamp sono salvati in UTC; giorni e anni si contano in UTC+1 tutto l'anno, come fa ARPAE.
- I limiti di legge stanno in un seed, mai nell'SQL di un modello.
- I valori negativi o impossibili vengono segnalati, non scartati.
- Gli stessi modelli girano su DuckDB in locale e su BigQuery nel cloud.
Architettura
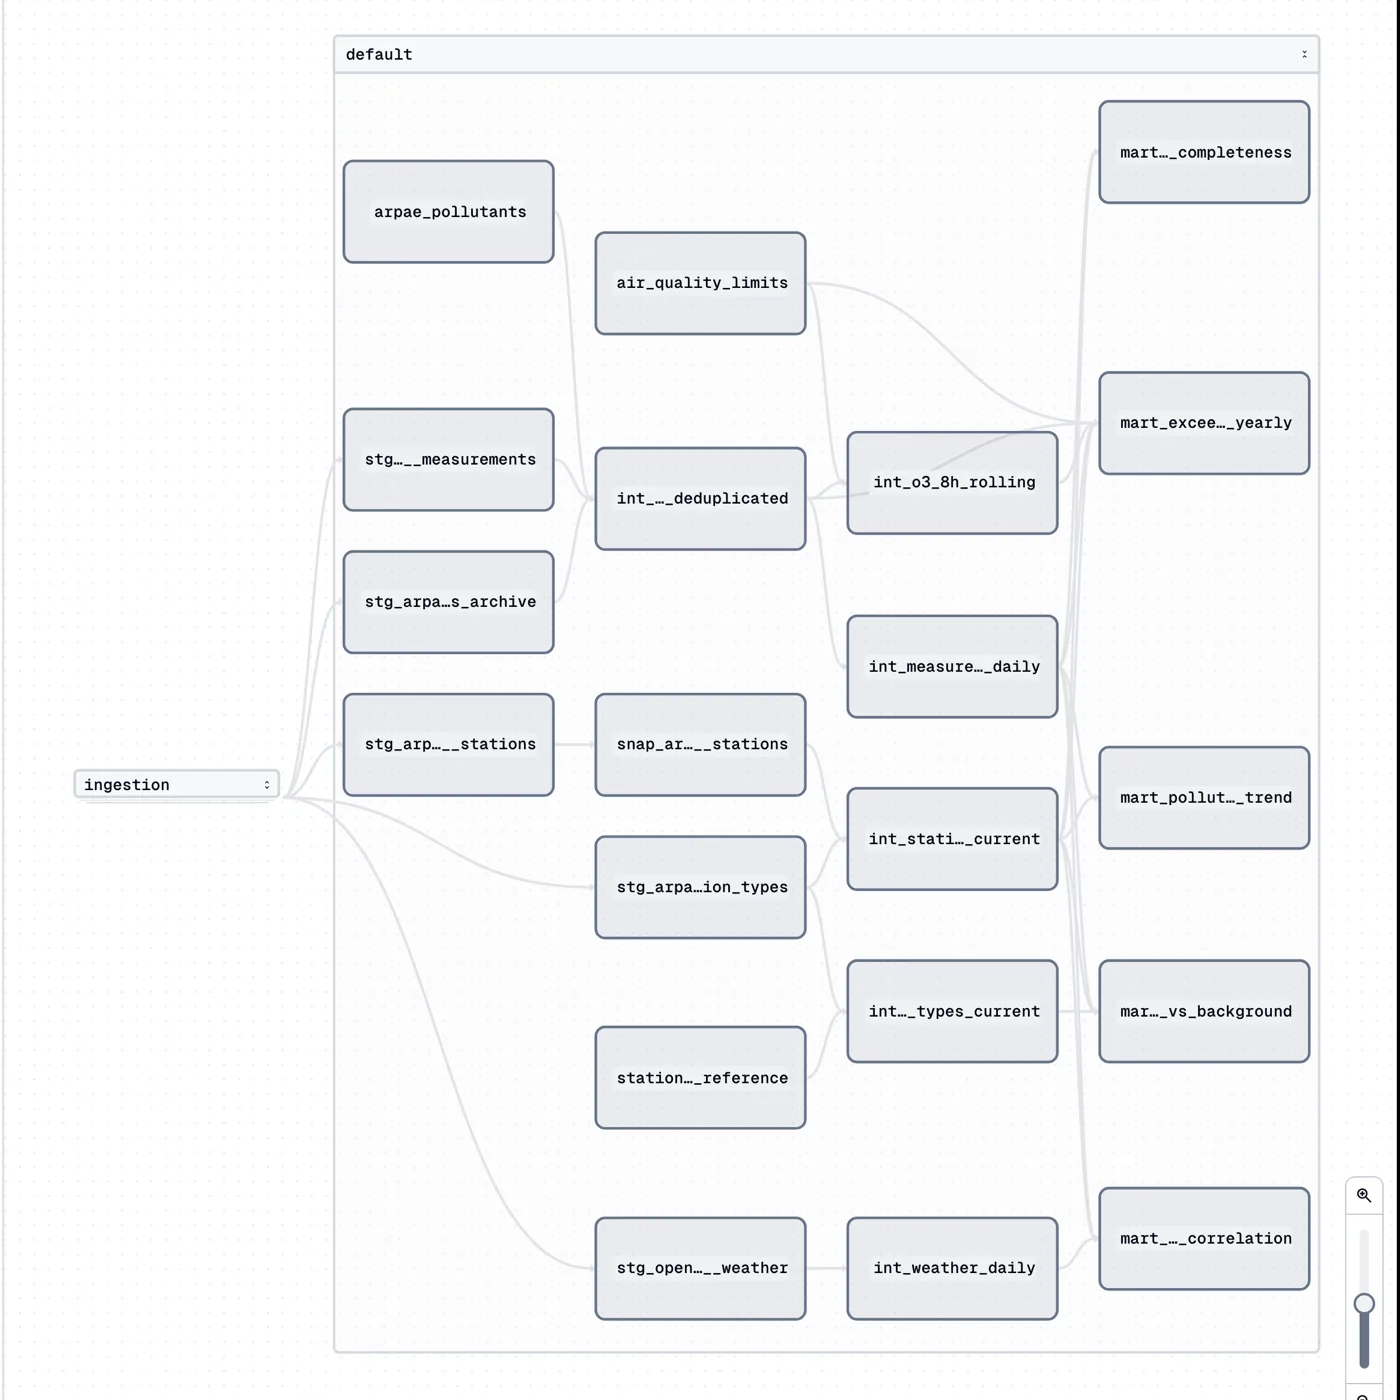
Quattro componenti, ognuno con un compito, collegati da file e tabelle invece che da chiamate: un binario Rust scrive Parquet partizionato, dbt ne ricava mart testati, Dagster pianifica e controlla entrambi, una dashboard legge soltanto i mart. Ogni riga dipende solo da quelle sotto.
dashboard
Streamlit: una query filtrata per mart, nessuna logica di business.
orchestration
Dagster: pianificazione giornaliera, partizioni mensili, backfill, controlli su freschezza e completezza.
transform
dbt: staging, intermediate e mart, con più di cento test.
aq-ingest
Workspace Rust: client ARPAE e Open-Meteo dietro un trait di sorgente, retry con backoff.
raw/
Parquet partizionato per anno e mese, ogni partizione riscritta in modo atomico, su disco o su Cloud Storage.
Un comando avvia tutto con Docker su un portatile; il target cloud scrive su Cloud Storage e costruisce gli stessi modelli su BigQuery.
Un giorno di dati, dall'inizio alla fine
L'aggiornamento giornaliero:
- 01Dagster
All'ora prevista avvia l'aggiornamento del mese corrente, un'esecuzione alla volta.
- 02Ingestor
Scarica gli ultimi 30 giorni dall'archivio ARPAE e il meteo da Open-Meteo, e riscrive ogni mese toccato come un unico file Parquet.
- 03dbt
Normalizza le unità, toglie i duplicati, unisce le righe nuove e ricostruisce i mart. Un test che fallisce ferma l'esecuzione.
- 04Dagster
I suoi controlli avvisano quando l'ultimo valore ha più di 48 ore o quando la completezza cala.
- 05Dashboard
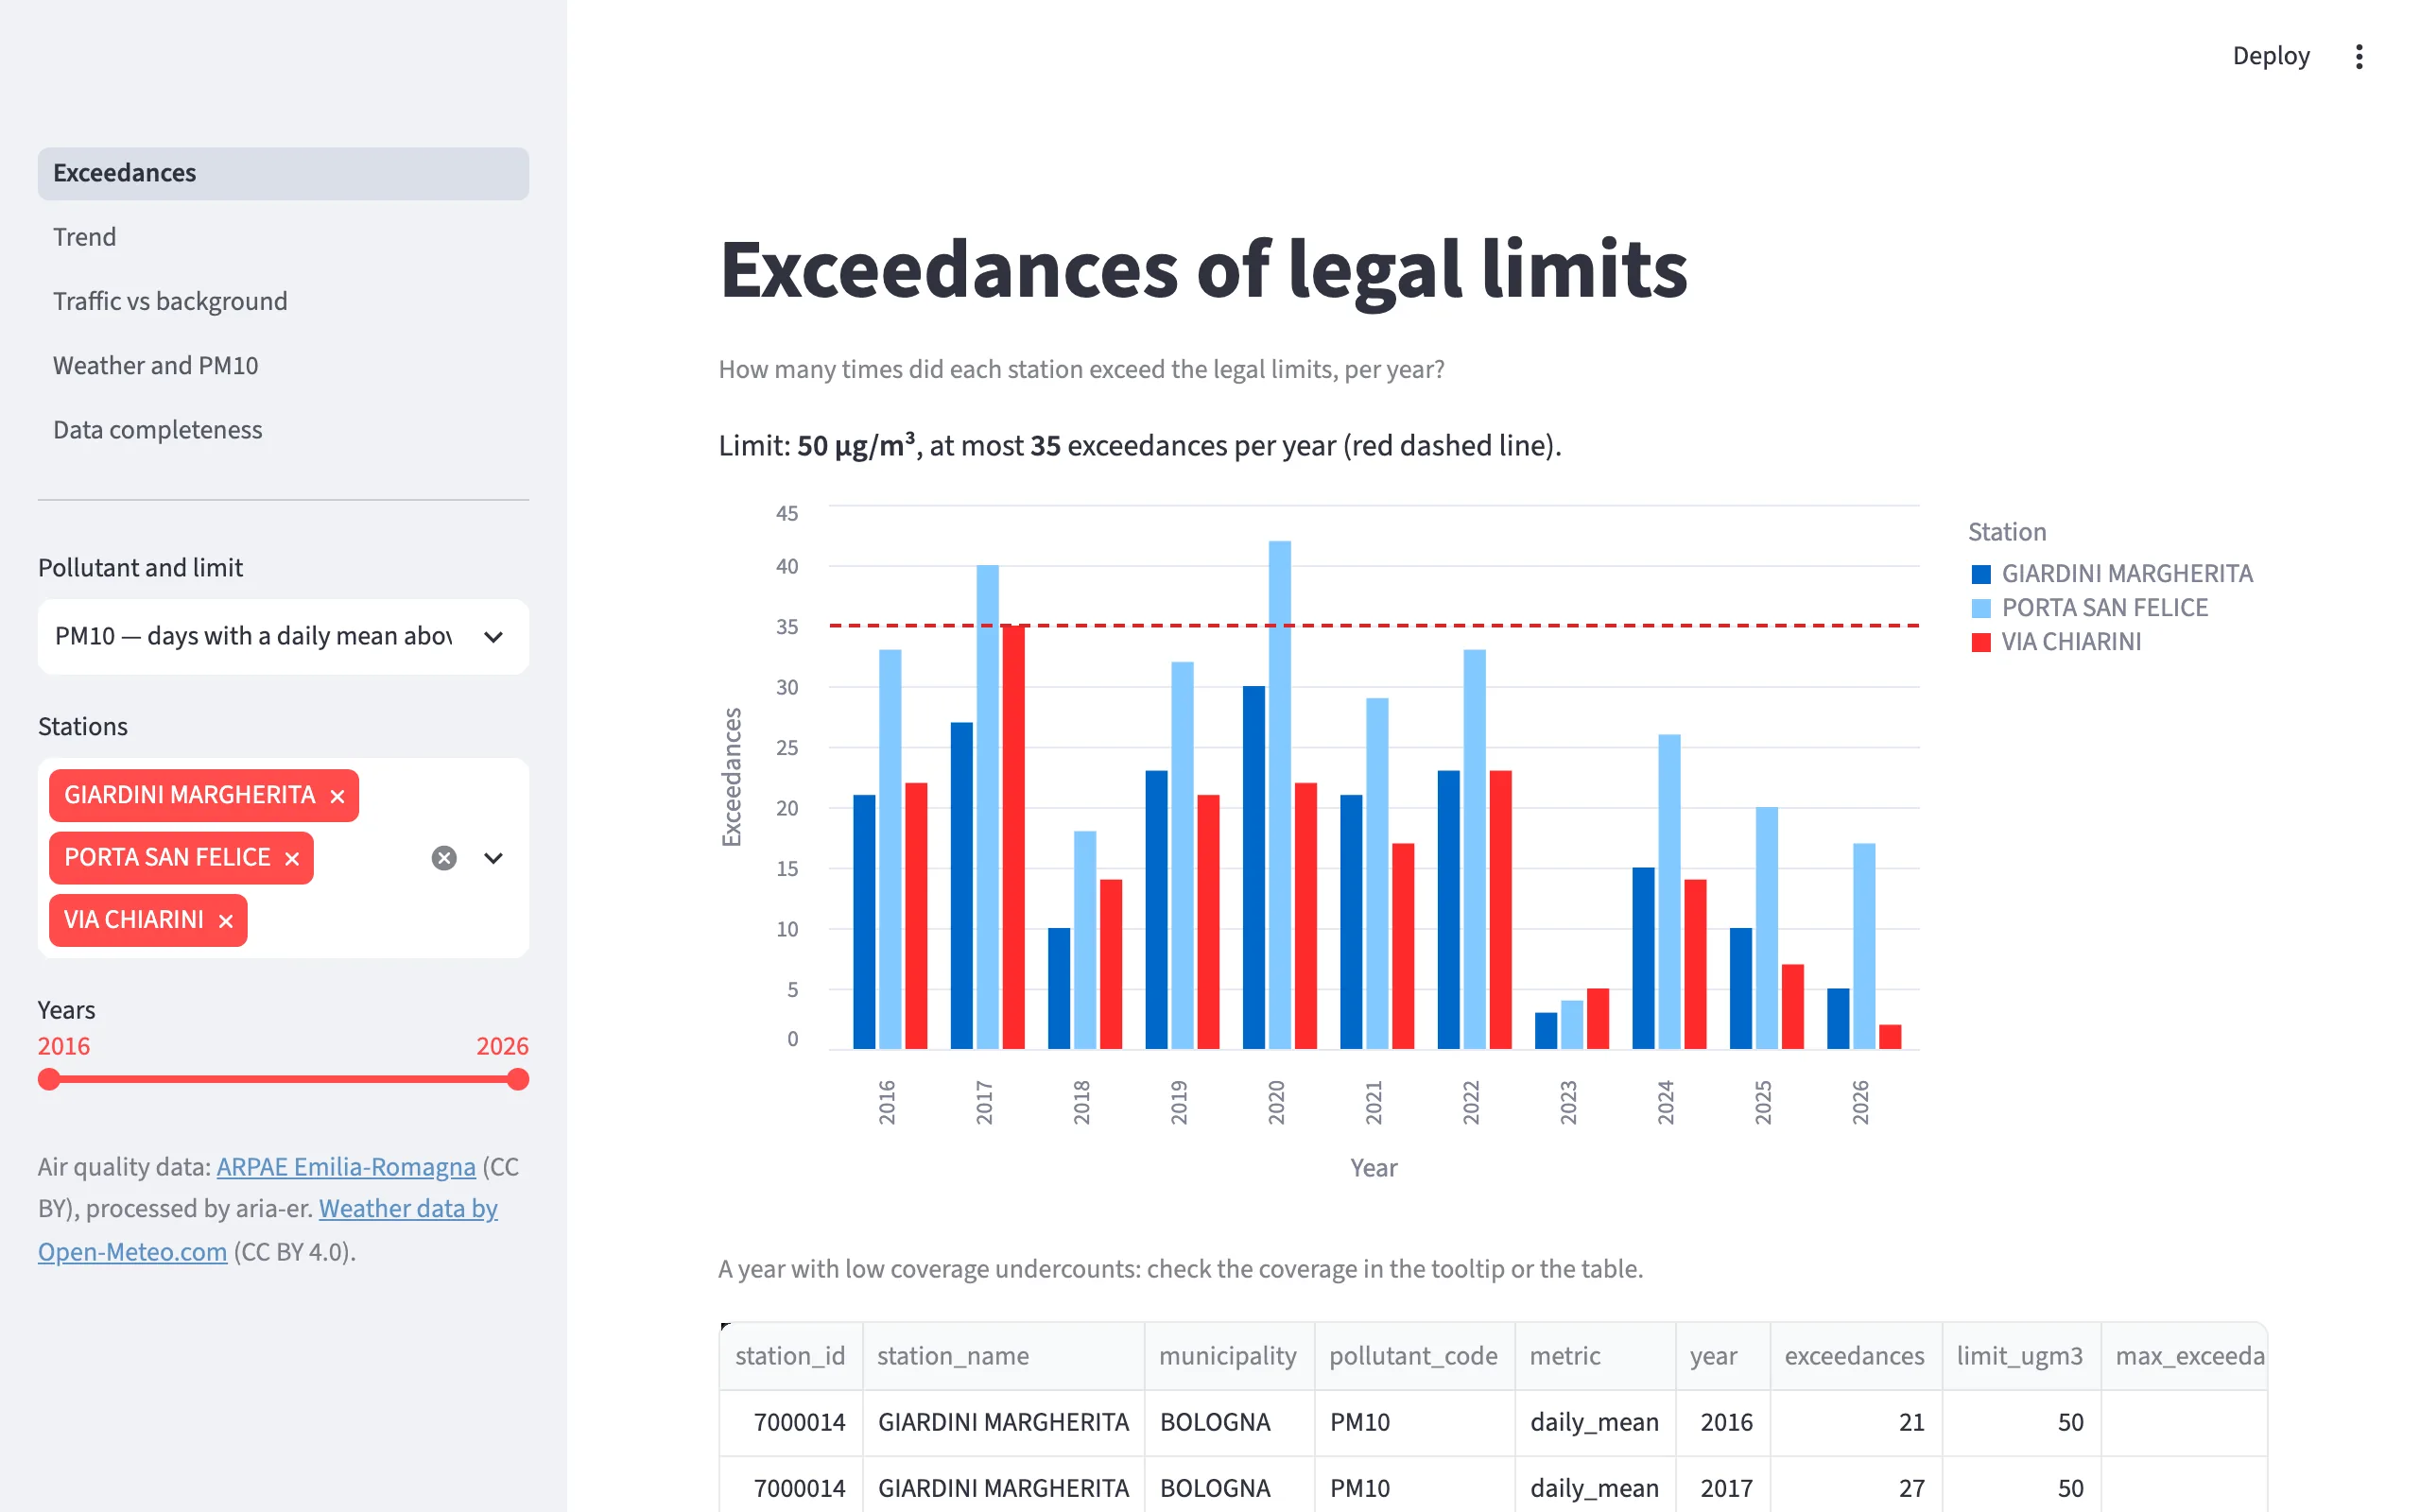
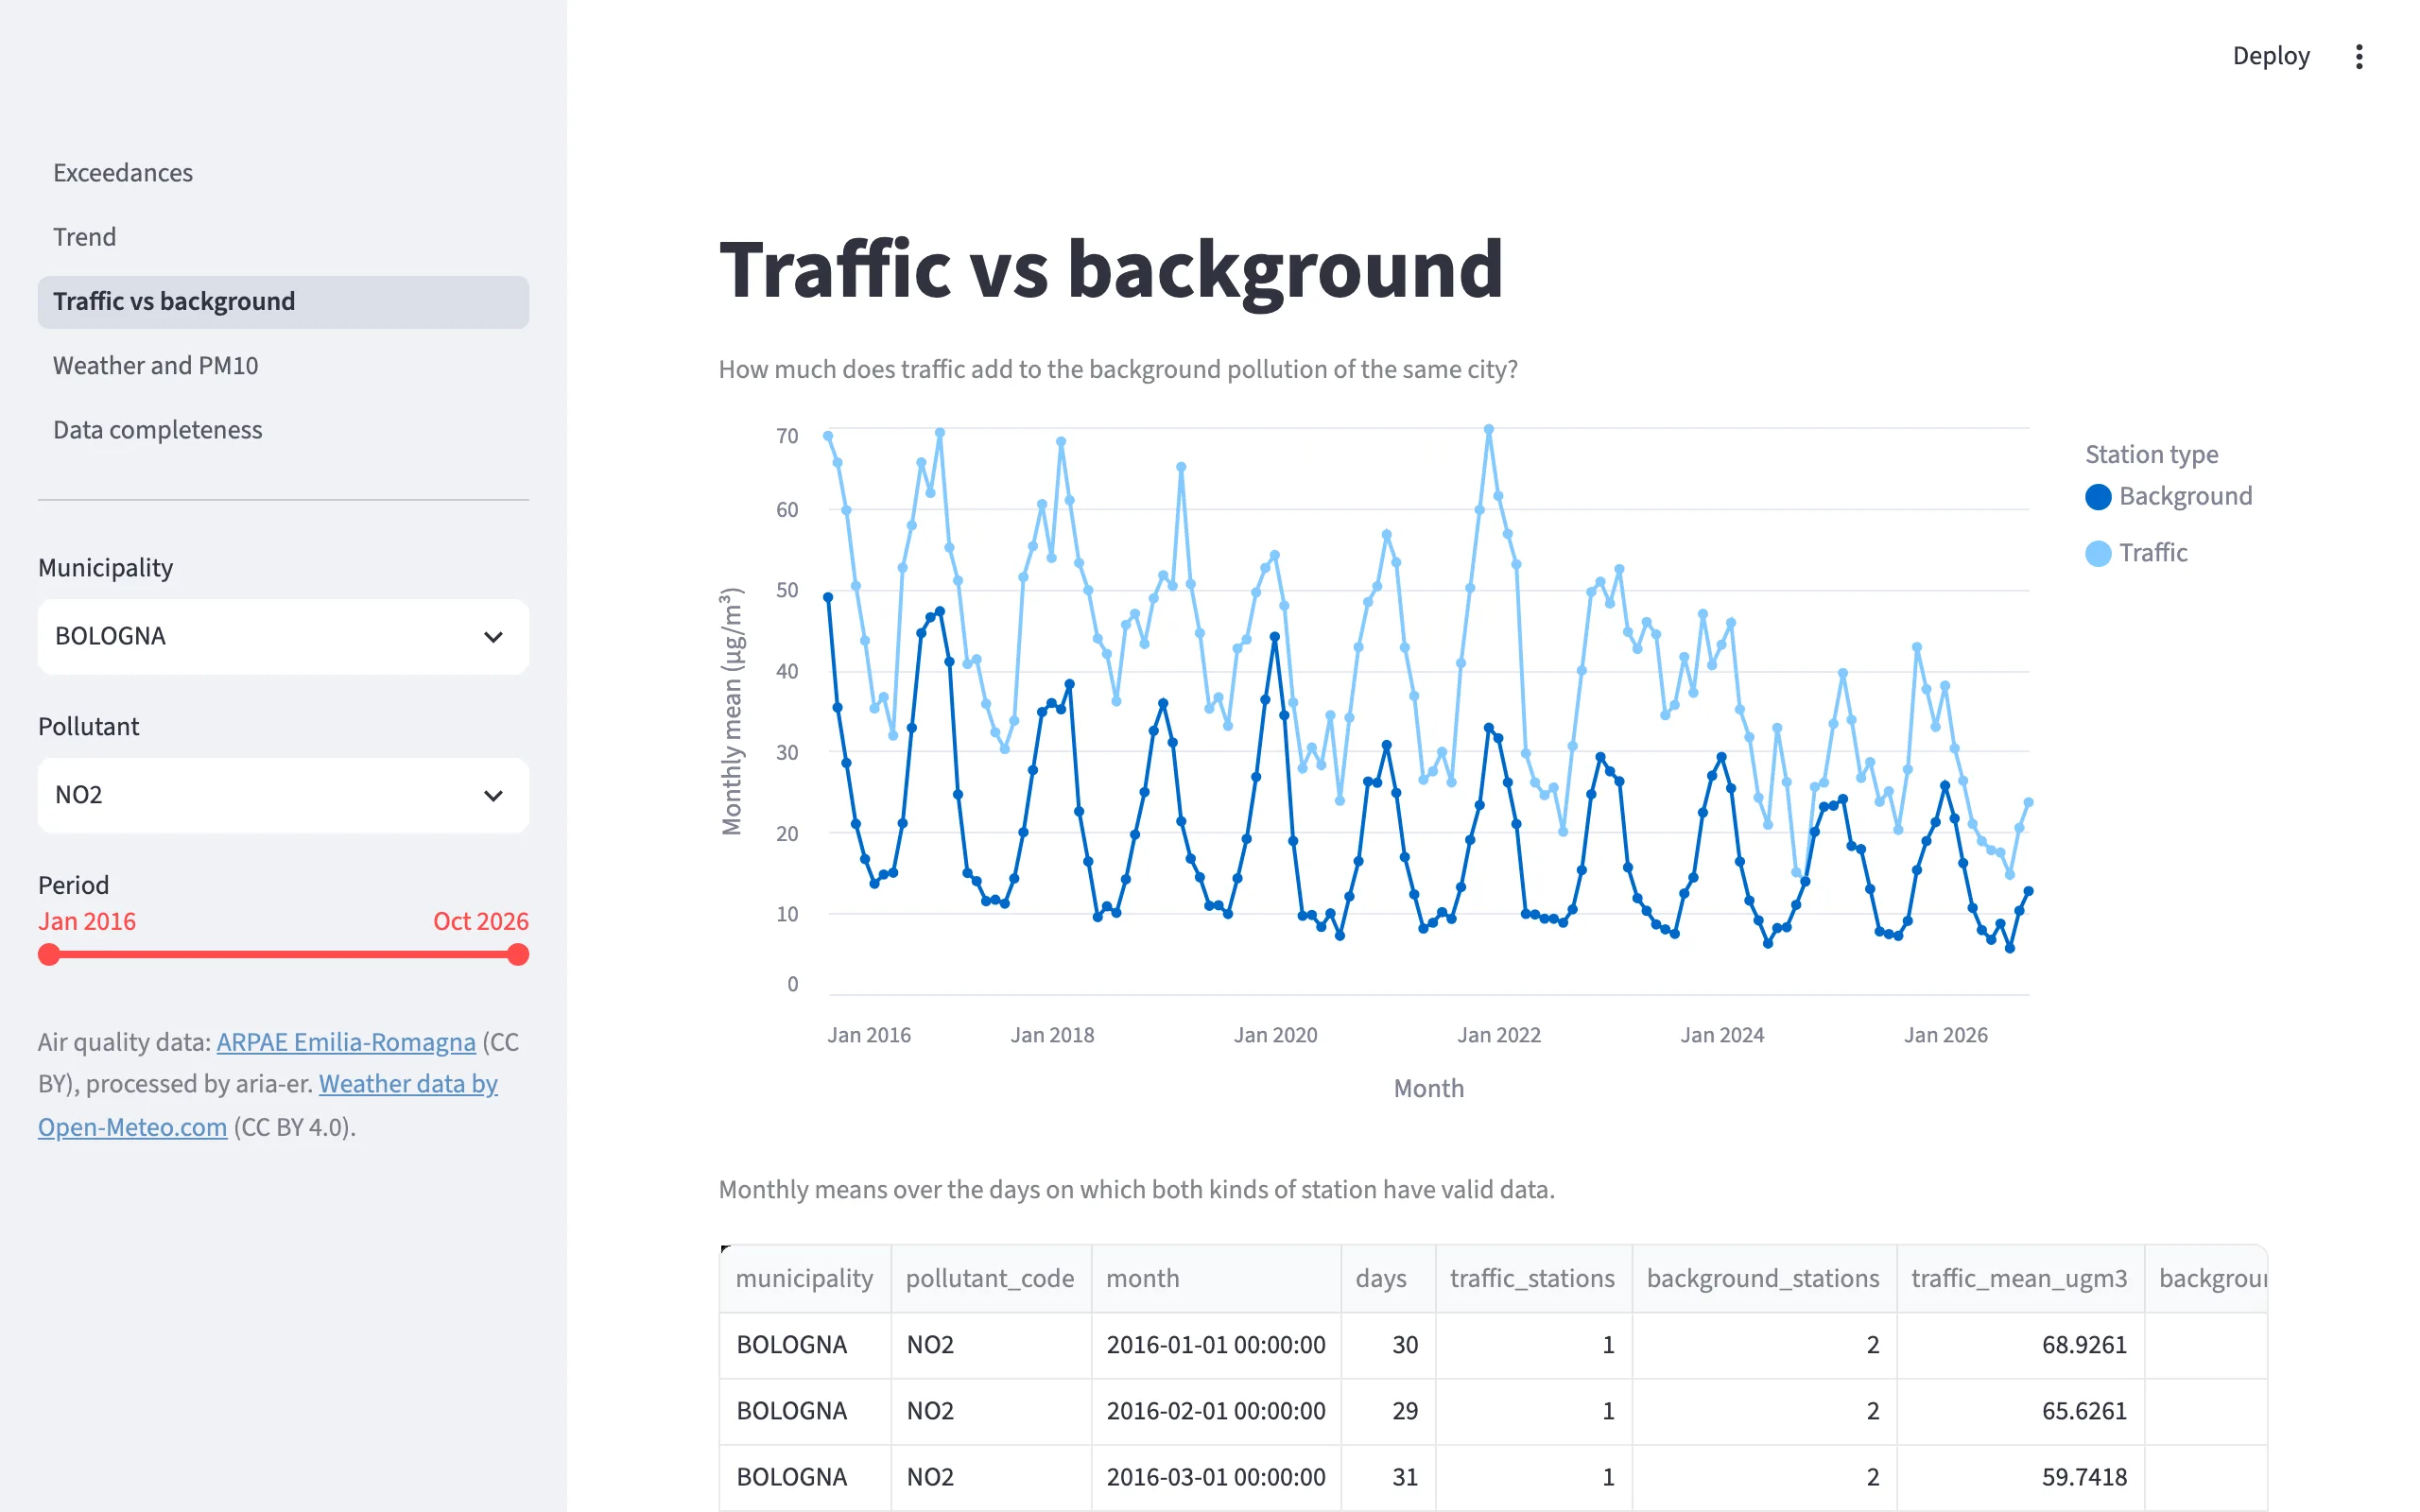
Legge i mart: superamenti, andamenti, traffico contro fondo, meteo, completezza.
Scelte e compromessi
- 01
Riscrivere una partizione, mai accodare
Ogni mese è un file Parquet, riscritto per intero con le righe unite e sostituito in modo atomico. Rieseguire una finestra dà gli stessi byte; il prezzo è riscrivere un mese per cambiare un'ora, poco a queste dimensioni.
- 02
Le regole di legge, non una media qualsiasi
Un giorno conta solo con 18 ore valide, il valore si arrotonda prima del confronto con il limite, il giorno è in UTC+1. Togliendo anche una sola di queste regole i conteggi non coincidevano più con quelli di ARPAE.
- 03
Segnalare, non scartare
I valori negativi, nulli o non plausibili restano nei dati con un segnale e fuori dagli aggregati. Due test di avviso li tengono visibili invece di farli sparire in silenzio.
- 04
Un solo insieme di modelli, due warehouse
L'SQL che cambia tra DuckDB e BigQuery sta in poche macro. Un emulatore verifica la versione BigQuery a ogni pull request, e l'esecuzione su un vero progetto Google Cloud ha dato mart identici.
- 05
Niente streaming
Le fonti pubblicano ore dopo la misura e correggono per mesi, e ogni domanda è giornaliera o più ampia. Basta un batch giornaliero; lo streaming aggiungerebbe solo parti in movimento.
Verificato con ARPAE
Ogni conteggio di superamenti è stato confrontato con quello che pubblica ARPAE. Due verifiche hanno cambiato il codice: il PM10 coincideva solo arrotondando il valore giornaliero prima del confronto, e l'ozono coincideva per 29 stazioni su 43 finché le finestre di 8 ore non sono state calcolate su ogni ora, anche quelle mancanti.
| Indicatore | ARPAE | aria-er |
|---|---|---|
| Giorni di PM10 oltre 50 µg/m³, Porta San Felice, 2025mart_exceedances_yearly | 20 | 20 |
| Giorni di ozono oltre 120 µg/m³, Via Chiarini, 2025mart_exceedances_yearly | 54 | 54 |
| Stazioni con gli stessi giorni di superamento del PM10 nel 2026mart_exceedances_yearly | 64 | 64 |
| Stazioni con gli stessi giorni di superamento dell'ozono nel 2026mart_exceedances_yearly | 43 | 43 |
Risultati dal vivo
I grafici qui sotto leggono l'export che aria-er pubblica ogni mattina su GitHub Pages: gli stessi mart della dashboard, aggiornati dalla pipeline stessa.
Caricamento degli ultimi dati…
Dashboard e pipeline
Cosa viene dopo
- Un export giornaliero dei mart pubblicato dalla pipeline, per mostrare i risultati aggiornati in questa pagina.
- Superamenti dell'ozono come media su tre anni, come chiede la legge, quando saranno caricati tre anni completi.
- Caricare l'archivio in una tabella nativa di BigQuery, se dovesse superare la quota gratuita di letture.
Codice
Il repository è pubblico, con licenza MIT. Un solo comando avvia tutto con Docker e carica dieci anni di dati.