(04) Systeme / Fallstudie
aria-er
Die Zahlen stimmen mit denen der ARPAE überein.
aria-er ist eine Datenplattform zur Luftqualität in der Emilia-Romagna: Open Data der ARPAE und Wetter von Open-Meteo, von der Ingestion bis zum Dashboard. Diese Seite zeigt, wie sie gebaut ist und wie ihre Ergebnisse geprüft wurden.
- Beginn
- September 2026
- Version
- 1.2.0, Oktober 2026
- Team
- Ein Entwickler
- Code
- Öffentlich, MIT
Rust · dbt · DuckDB · BigQuery · Dagster · Streamlit · Terraform · Docker
Das Problem
Die ARPAE veröffentlicht die Luftqualitätsmessungen der Emilia-Romagna als Open Data, aber nicht in einer Form, der man Fragen stellen kann: Stunden- und Tageswerte verteilt auf mehrere Dienste, wochenlang vorläufig und dann korrigiert, Stations-IDs, die sich von Datei zu Datei ändern.
Die Fragen sind einfach: wie oft jede Station die gesetzlichen Grenzwerte überschritten hat, ob die Luft besser wird, wie viel der Verkehr zur Hintergrundbelastung beiträgt, wie Wind und Regen den Feinstaub beeinflussen. Sie mit verlässlichen Zahlen zu beantworten, ist die Arbeit.
Rahmenbedingungen
- Neuere Werte werden wochenlang korrigiert: Jeder Lauf verarbeitet ein Fenster von 30 Tagen neu und aktualisiert nach Station, Schadstoff und Stunde. Dasselbe Fenster zweimal ergibt dieselben Dateien.
- Zeitstempel werden in UTC gespeichert; Tage und Jahre zählen das ganze Jahr in UTC+1, wie bei der ARPAE.
- Gesetzliche Grenzwerte stehen in einem Seed, nie im SQL eines Modells.
- Negative oder unmögliche Werte werden markiert, nicht verworfen.
- Dieselben Modelle laufen auf DuckDB auf dem Laptop und auf BigQuery in der Cloud.
Architektur
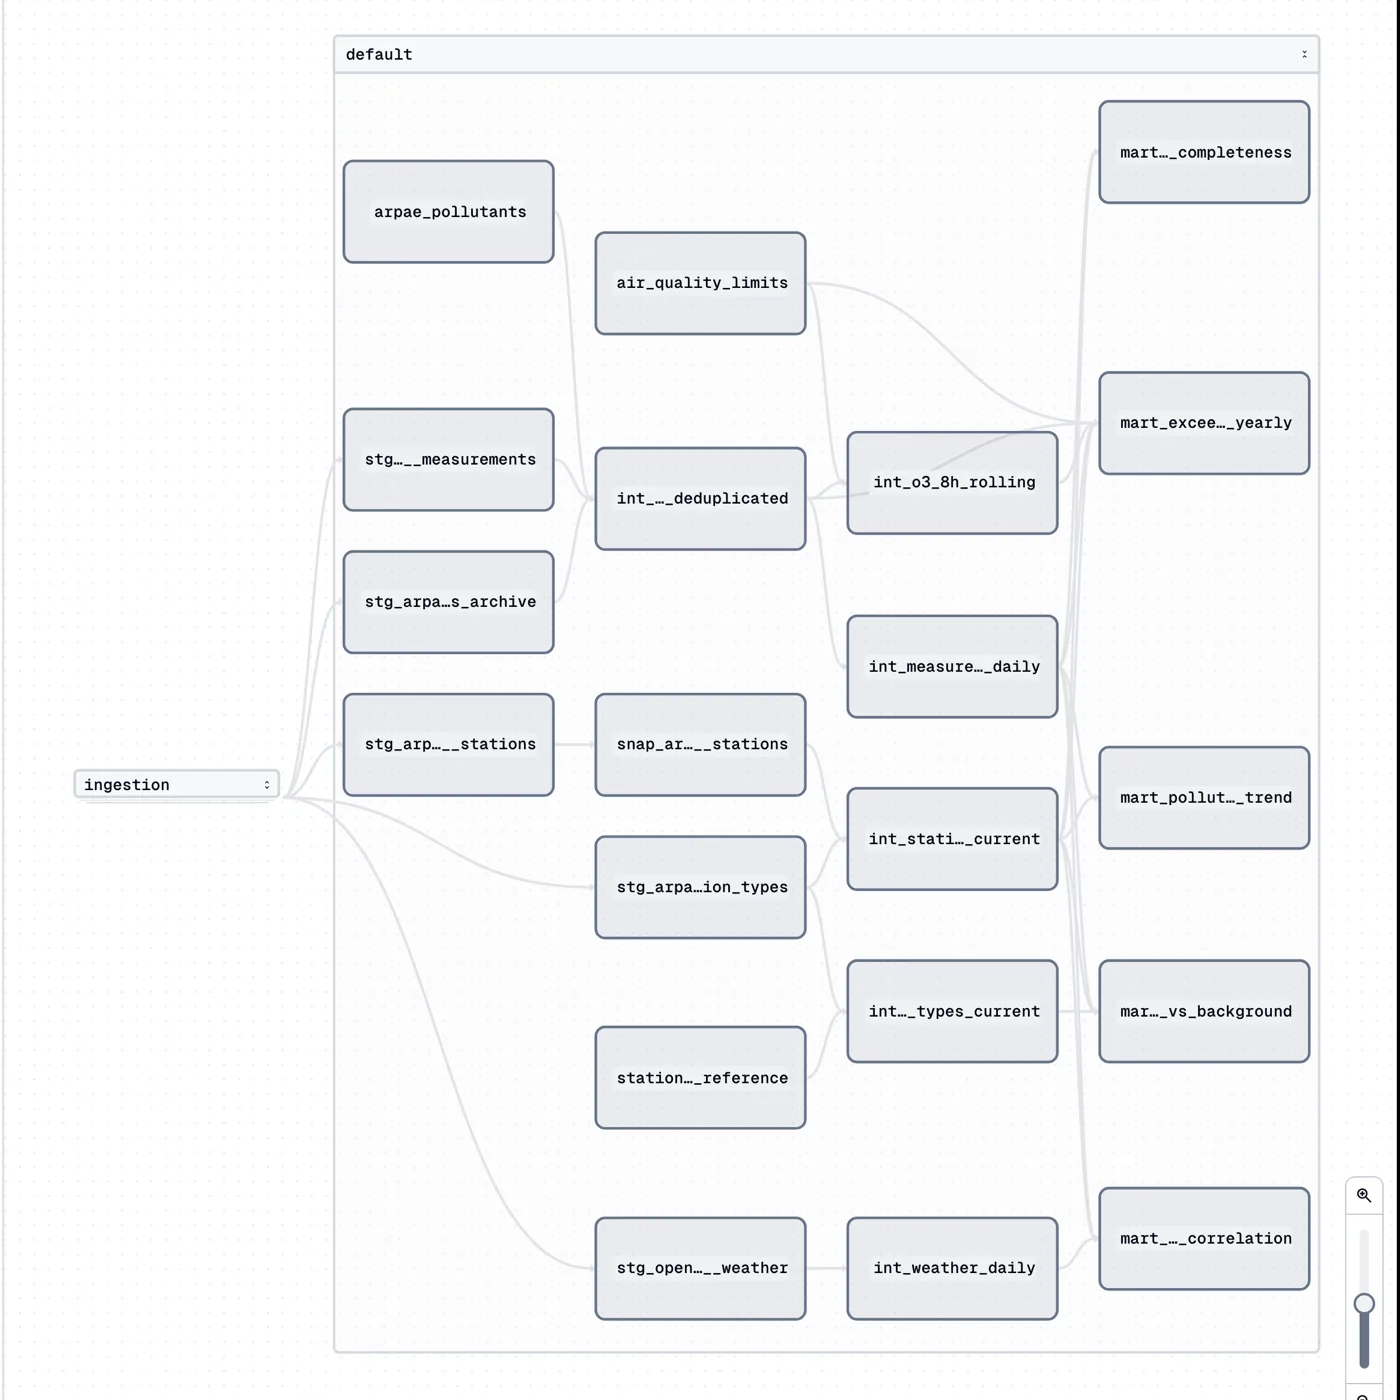
Vier Komponenten mit je einer Aufgabe, verbunden über Dateien und Tabellen statt über Aufrufe: Ein Rust-Binary schreibt partitioniertes Parquet, dbt macht daraus getestete Marts, Dagster plant und prüft beides, ein Dashboard liest nur die Marts. Jede Zeile hängt nur von den Zeilen darunter ab.
dashboard
Streamlit: eine gefilterte Abfrage pro Mart, keine Geschäftslogik.
orchestration
Dagster: täglicher Zeitplan, monatliche Partitionen, Backfills, Prüfungen auf Aktualität und Vollständigkeit.
transform
dbt: Staging, Intermediate und Marts, mit mehr als hundert Tests.
aq-ingest
Rust-Workspace: Clients für ARPAE und Open-Meteo hinter einem Source-Trait, Wiederholungen mit Backoff.
raw/
Parquet, nach Jahr und Monat partitioniert, jede Partition atomar neu geschrieben, auf der Festplatte oder in Cloud Storage.
Ein Befehl startet alles mit Docker auf dem Laptop; das Cloud-Ziel schreibt nach Cloud Storage und baut dieselben Modelle in BigQuery.
Ein Tag Daten, von Anfang bis Ende
Die tägliche Aktualisierung:
- 01Dagster
Zur geplanten Stunde startet es die Aktualisierung des laufenden Monats, ein Lauf nach dem anderen.
- 02Ingestor
Er lädt die letzten 30 Tage aus dem Archiv der ARPAE und das Wetter von Open-Meteo und schreibt jeden betroffenen Monat als eine Parquet-Datei neu.
- 03dbt
Es vereinheitlicht die Einheiten, entfernt Duplikate, führt die neuen Zeilen zusammen und baut die Marts neu. Ein fehlgeschlagener Test stoppt den Lauf.
- 04Dagster
Seine Prüfungen warnen, wenn der neueste Wert älter als 48 Stunden ist oder die Vollständigkeit sinkt.
- 05Dashboard
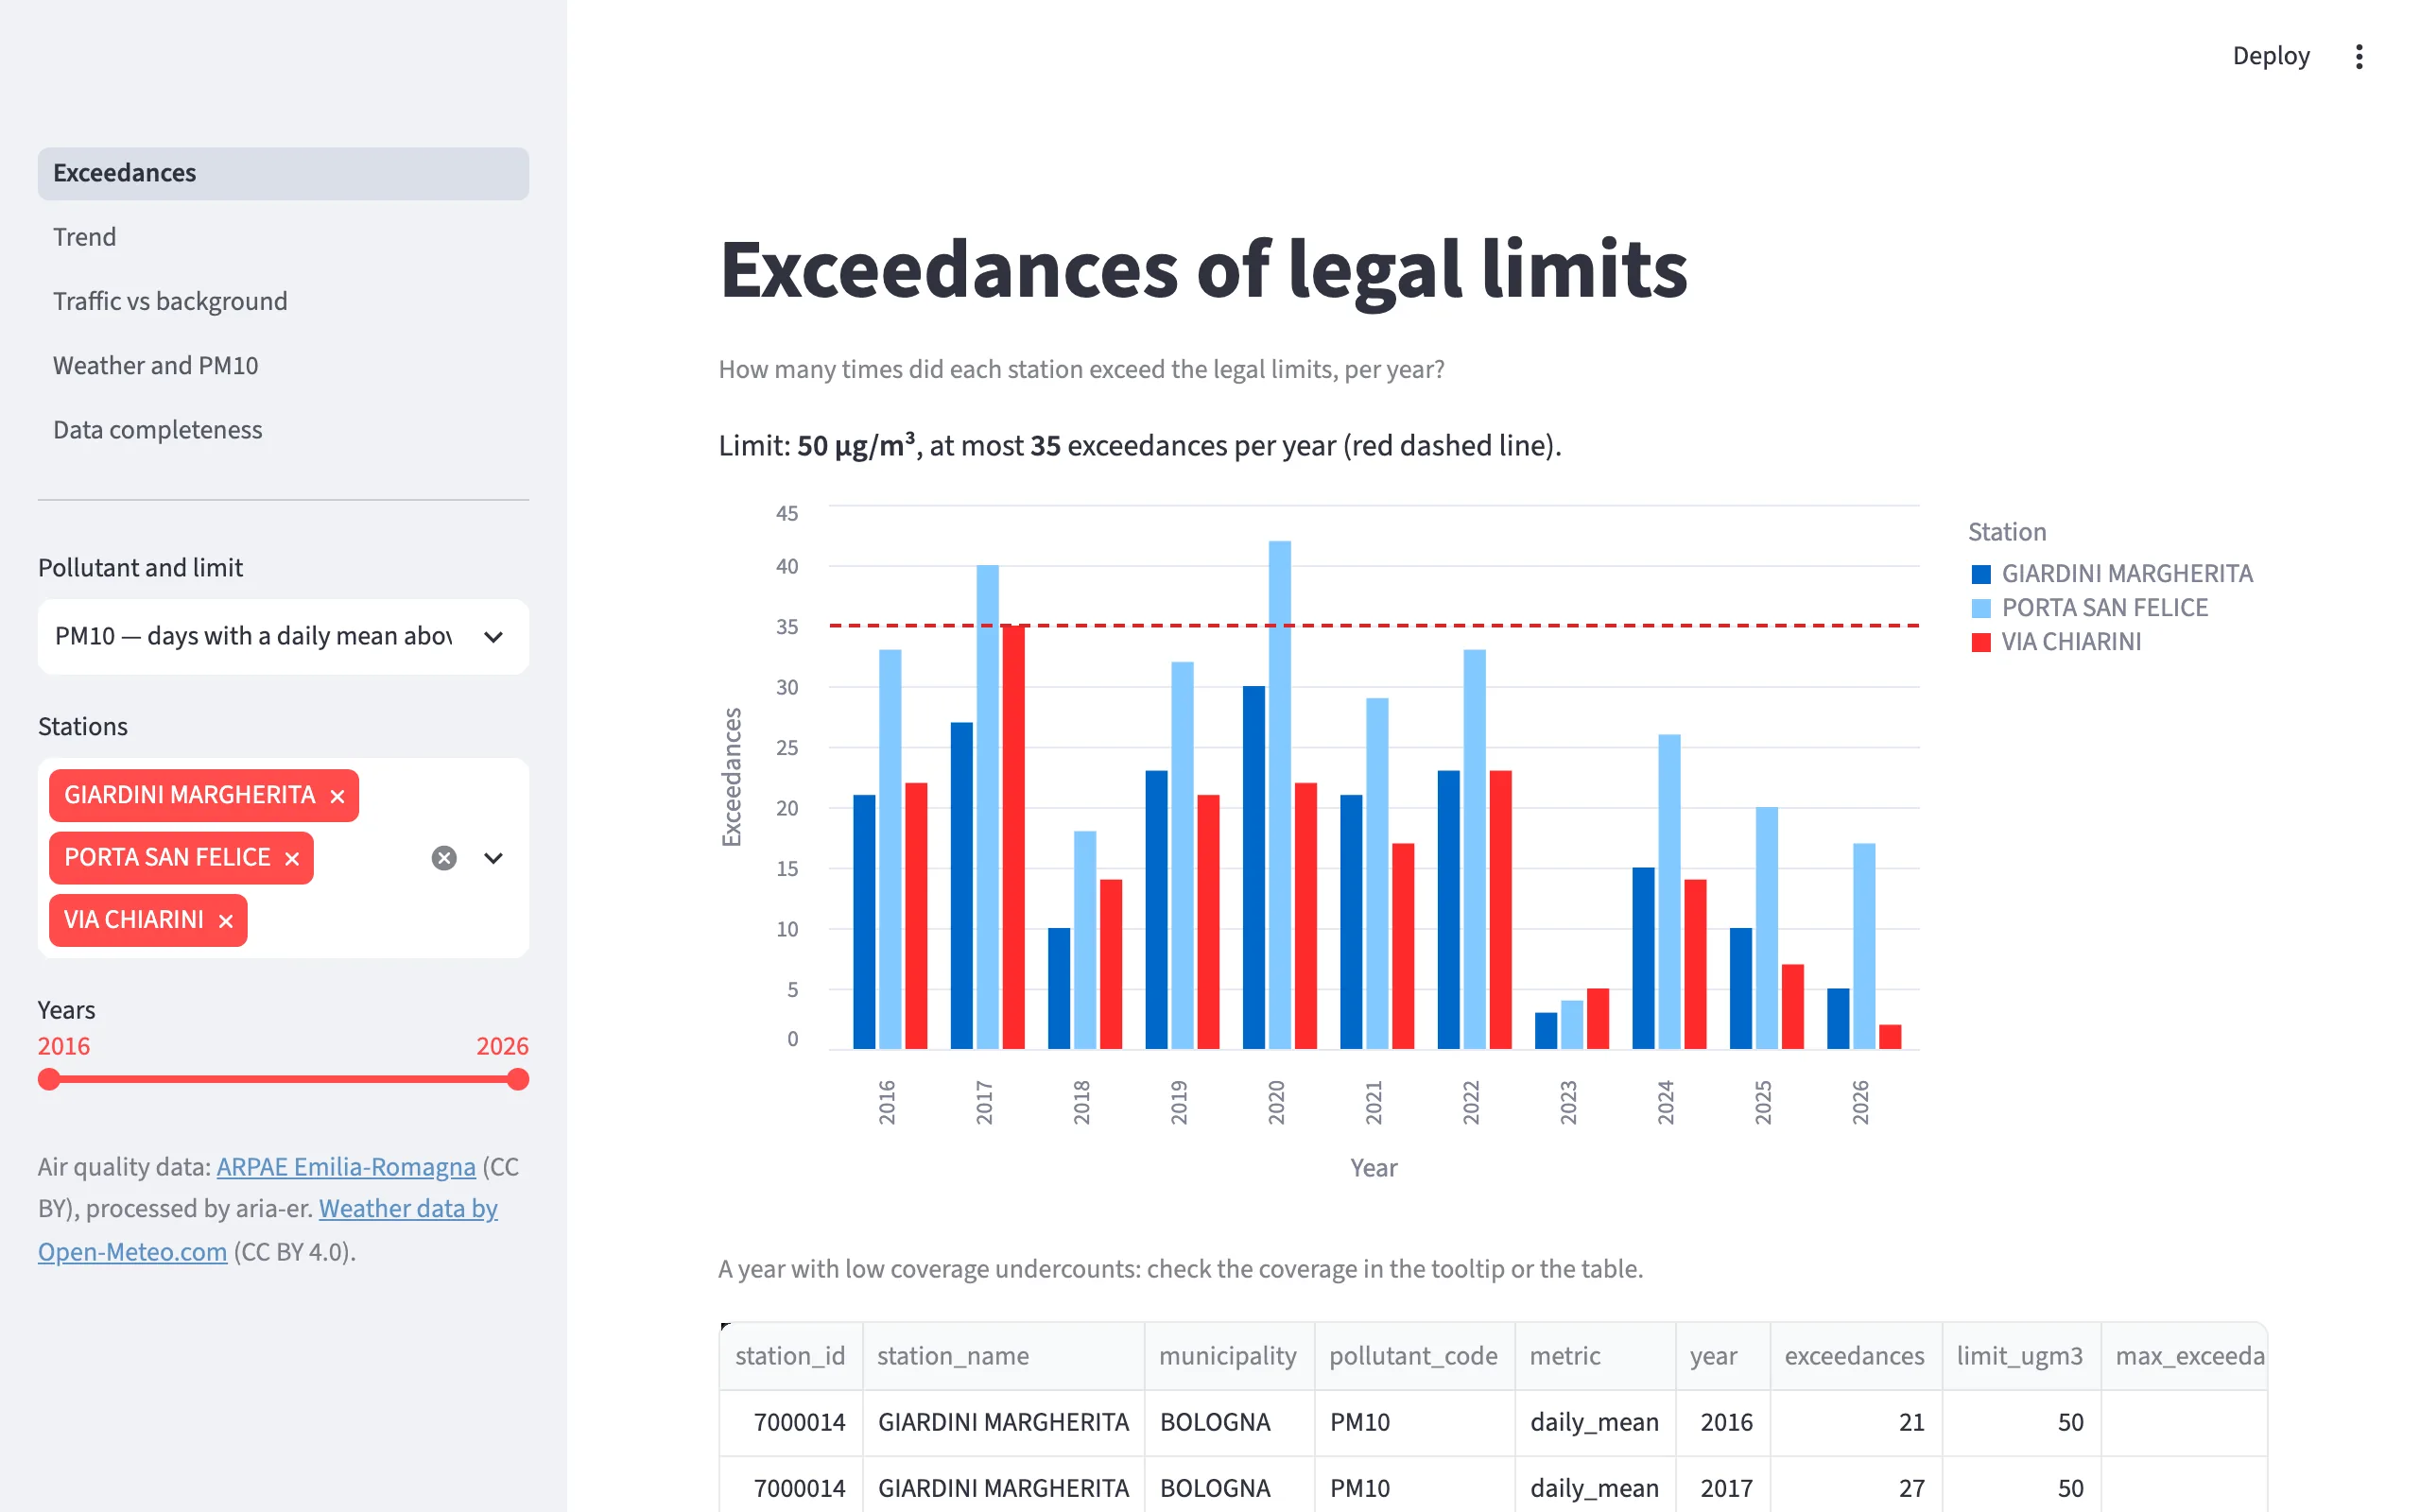
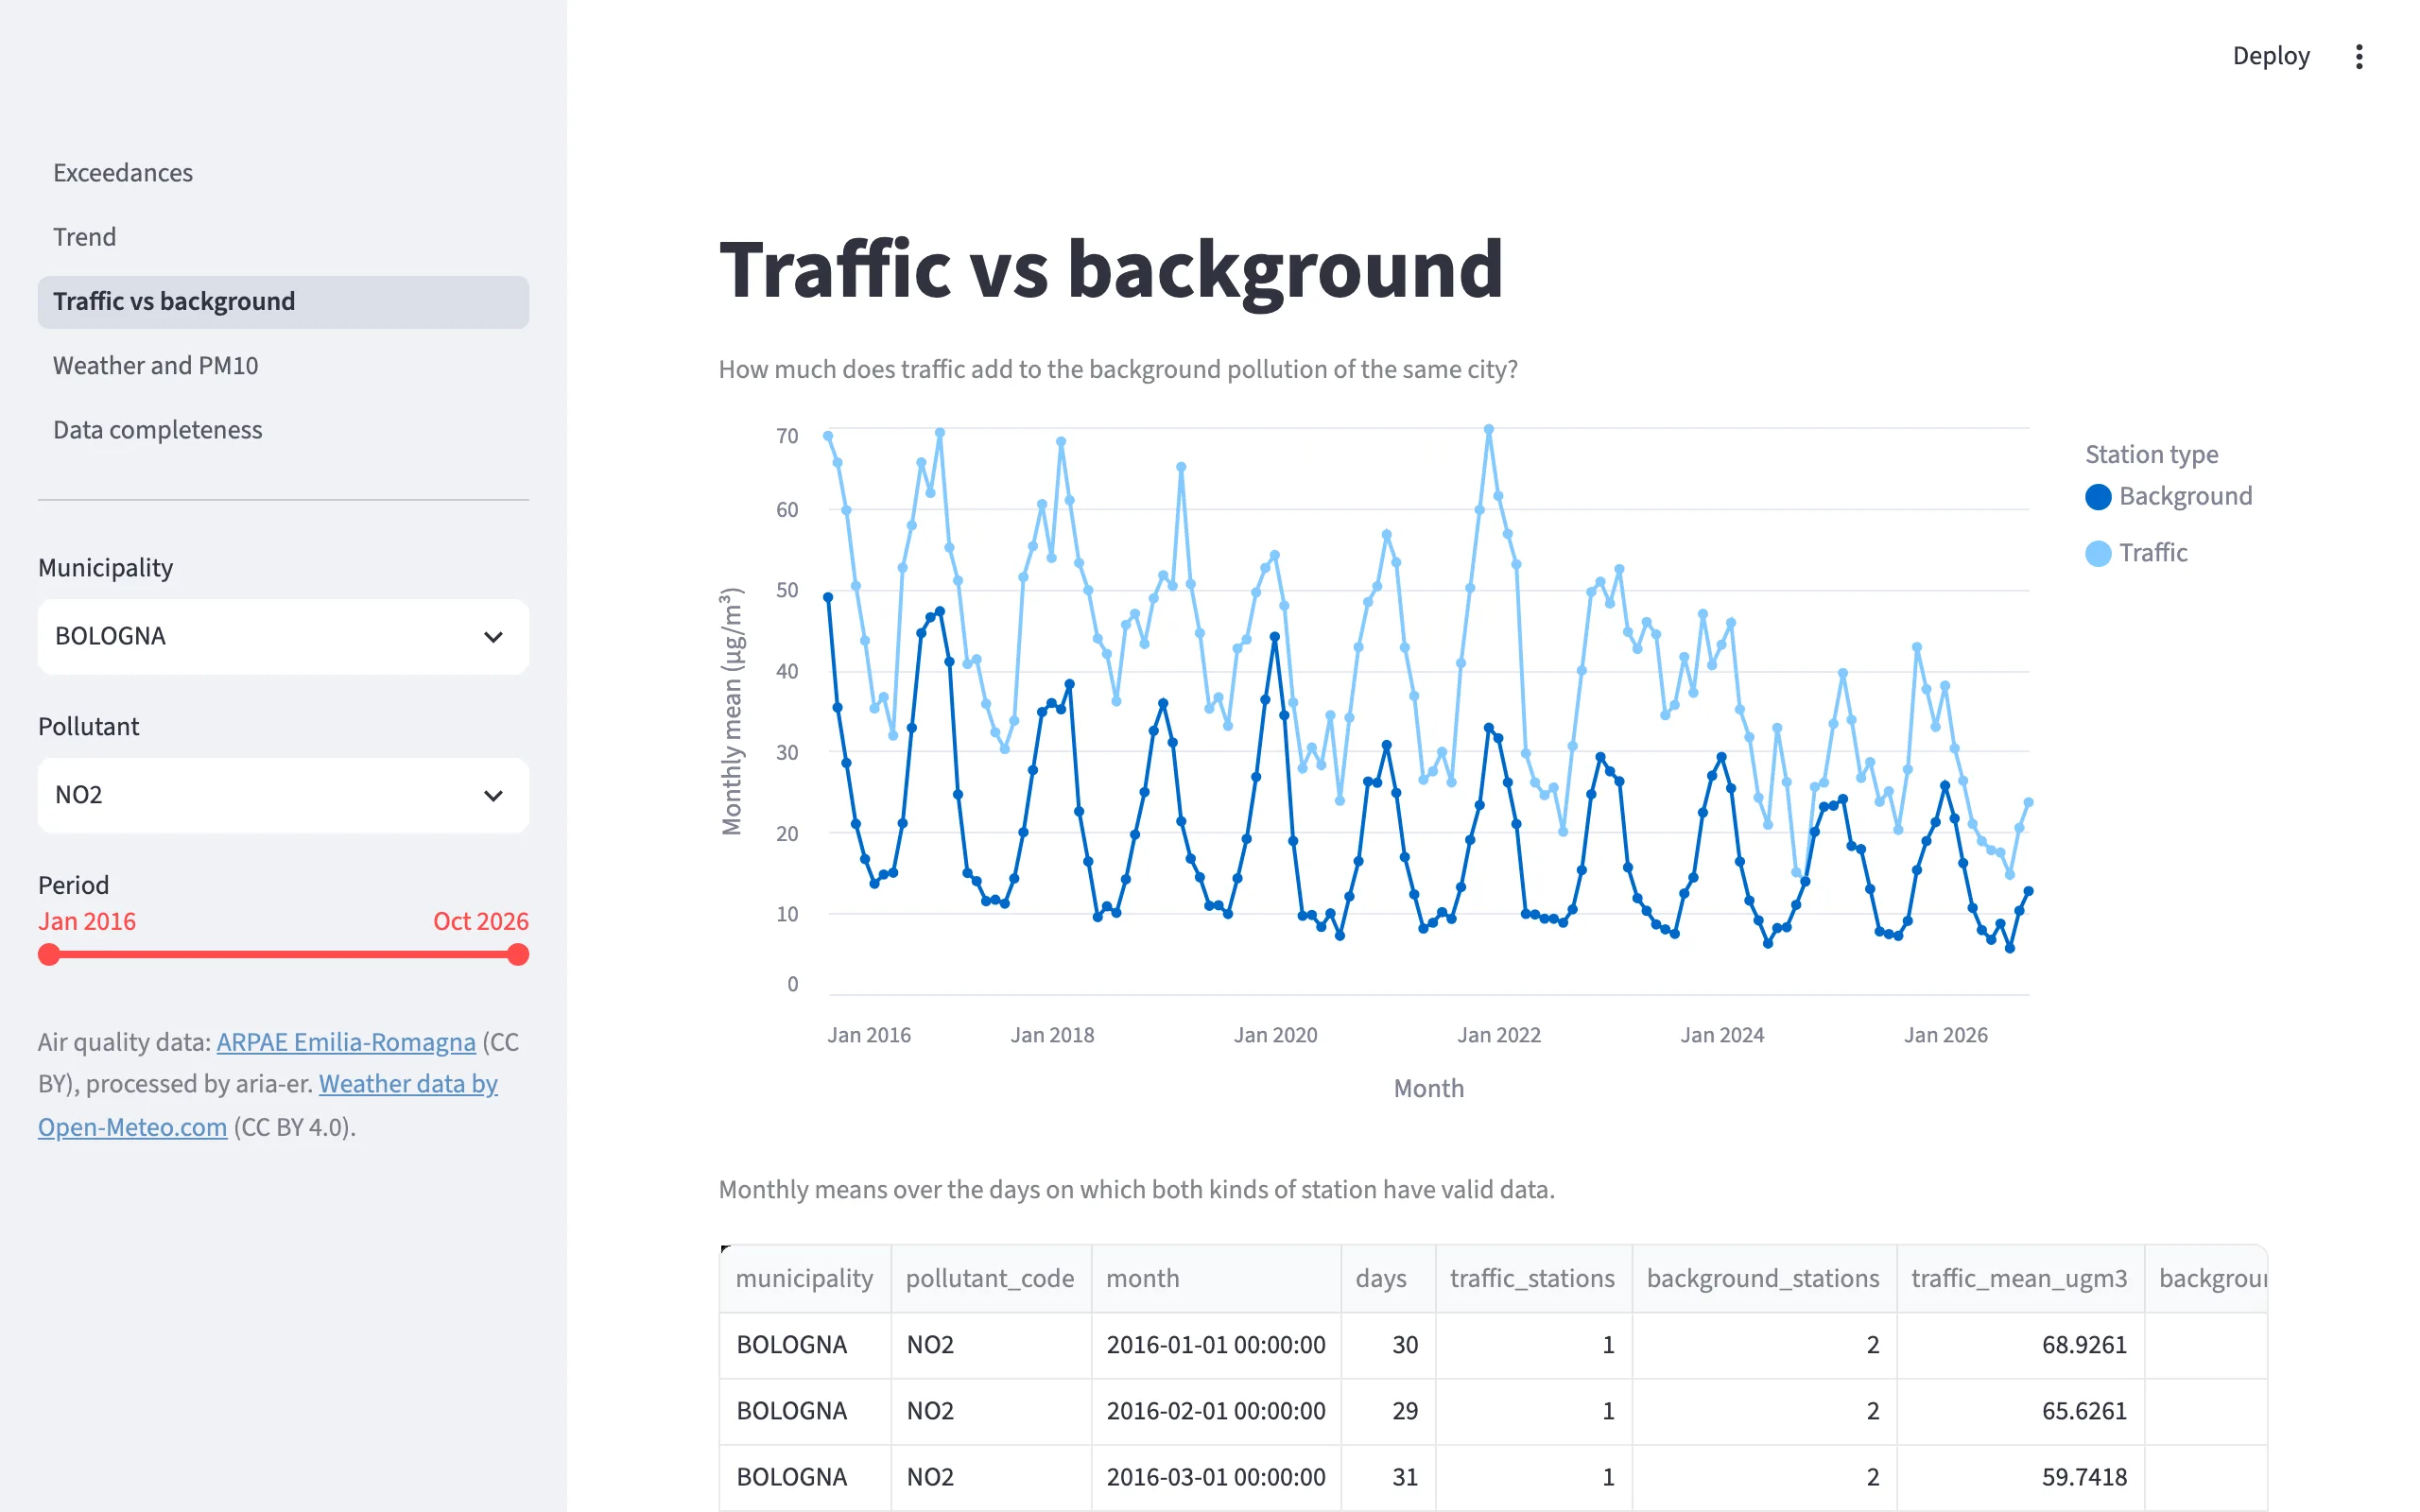
Es liest die Marts: Überschreitungen, Trends, Verkehr gegen Hintergrund, Wetter, Vollständigkeit.
Entscheidungen und Abwägungen
- 01
Eine Partition neu schreiben, nie anhängen
Jeder Monat ist eine Parquet-Datei, die mit den zusammengeführten Zeilen komplett neu geschrieben und atomar ersetzt wird. Ein erneuter Lauf ergibt dieselben Bytes; der Preis ist, einen Monat neu zu schreiben, um eine Stunde zu ändern, bei dieser Größe billig.
- 02
Die gesetzlichen Regeln, kein einfacher Mittelwert
Ein Tag zählt nur mit 18 gültigen Stunden, der Wert wird vor dem Vergleich mit dem Grenzwert gerundet, der Tag läuft in UTC+1. Ohne eine dieser Regeln wichen die Zählungen von denen der ARPAE ab.
- 03
Markieren, nicht verwerfen
Negative, null und unplausible Werte bleiben mit einer Markierung in den Daten und außerhalb der Aggregate. Zwei Warn-Tests halten sie sichtbar, statt sie still verschwinden zu lassen.
- 04
Ein Satz Modelle, zwei Warehouses
Das SQL, das sich zwischen DuckDB und BigQuery unterscheidet, steckt in wenigen Makros. Ein Emulator prüft die BigQuery-Version bei jedem Pull Request, und der Lauf in einem echten Projekt auf Google Cloud ergab identische Marts.
- 05
Kein Streaming
Die Quellen veröffentlichen Stunden nach der Messung und korrigieren monatelang, und jede Frage ist täglich oder gröber. Ein täglicher Batch beantwortet sie; Streaming brächte nur bewegliche Teile hinzu.
Geprüft mit der ARPAE
Jede Zählung von Überschreitungen wurde mit dem verglichen, was die ARPAE selbst veröffentlicht. Zwei Prüfungen haben den Code verändert: Beim Feinstaub stimmten die Zahlen erst, als der Tageswert vor dem Vergleich gerundet wurde, und beim Ozon stimmten 29 von 43 Stationen, bis die 8-Stunden-Fenster für jede Stunde berechnet wurden, auch für fehlende.
| Indikator | ARPAE | aria-er |
|---|---|---|
| Tage mit PM10 über 50 µg/m³, Porta San Felice, 2025mart_exceedances_yearly | 20 | 20 |
| Tage mit Ozon über 120 µg/m³, Via Chiarini, 2025mart_exceedances_yearly | 54 | 54 |
| Stationen mit denselben PM10-Überschreitungstagen 2026mart_exceedances_yearly | 64 | 64 |
| Stationen mit denselben Ozon-Überschreitungstagen 2026mart_exceedances_yearly | 43 | 43 |
Ergebnisse, live
Die Diagramme unten lesen den Export, den aria-er jeden Morgen auf GitHub Pages veröffentlicht: dieselben Marts wie im Dashboard, von der Pipeline selbst aktualisiert.
Die neuesten Daten werden geladen…
Dashboard und Pipeline
Wie es weitergeht
- Ein täglicher Export der Marts, von der Pipeline veröffentlicht, um auf dieser Seite aktuelle Ergebnisse zu zeigen.
- Ozon-Überschreitungen im Dreijahresmittel, wie es das Gesetz verlangt, sobald drei volle Jahre geladen sind.
- Das Archiv in eine native BigQuery-Tabelle laden, falls es das kostenlose Lesekontingent übersteigt.
Code
Das Repository ist öffentlich, unter MIT-Lizenz. Ein einziger Befehl startet alles mit Docker und lädt zehn Jahre Daten.