(04) Sistemas / Caso de estudio
aria-er
Las cifras coinciden con las de ARPAE.
aria-er es una plataforma de datos sobre la calidad del aire en Emilia-Romaña: datos abiertos de ARPAE y meteorología de Open-Meteo, de la ingesta al dashboard. Esta página muestra cómo está hecha y cómo se verificaron sus resultados.
- Inicio
- Septiembre de 2026
- Versión
- 1.2.0, octubre de 2026
- Equipo
- Un desarrollador
- Código
- Público, MIT
Rust · dbt · DuckDB · BigQuery · Dagster · Streamlit · Terraform · Docker
El problema
ARPAE publica las mediciones de la calidad del aire de Emilia-Romaña como datos abiertos, pero no en una forma a la que se le puedan hacer preguntas: valores horarios y diarios repartidos en varios servicios, provisionales durante semanas y luego corregidos, identificadores de estación que cambian de un archivo a otro.
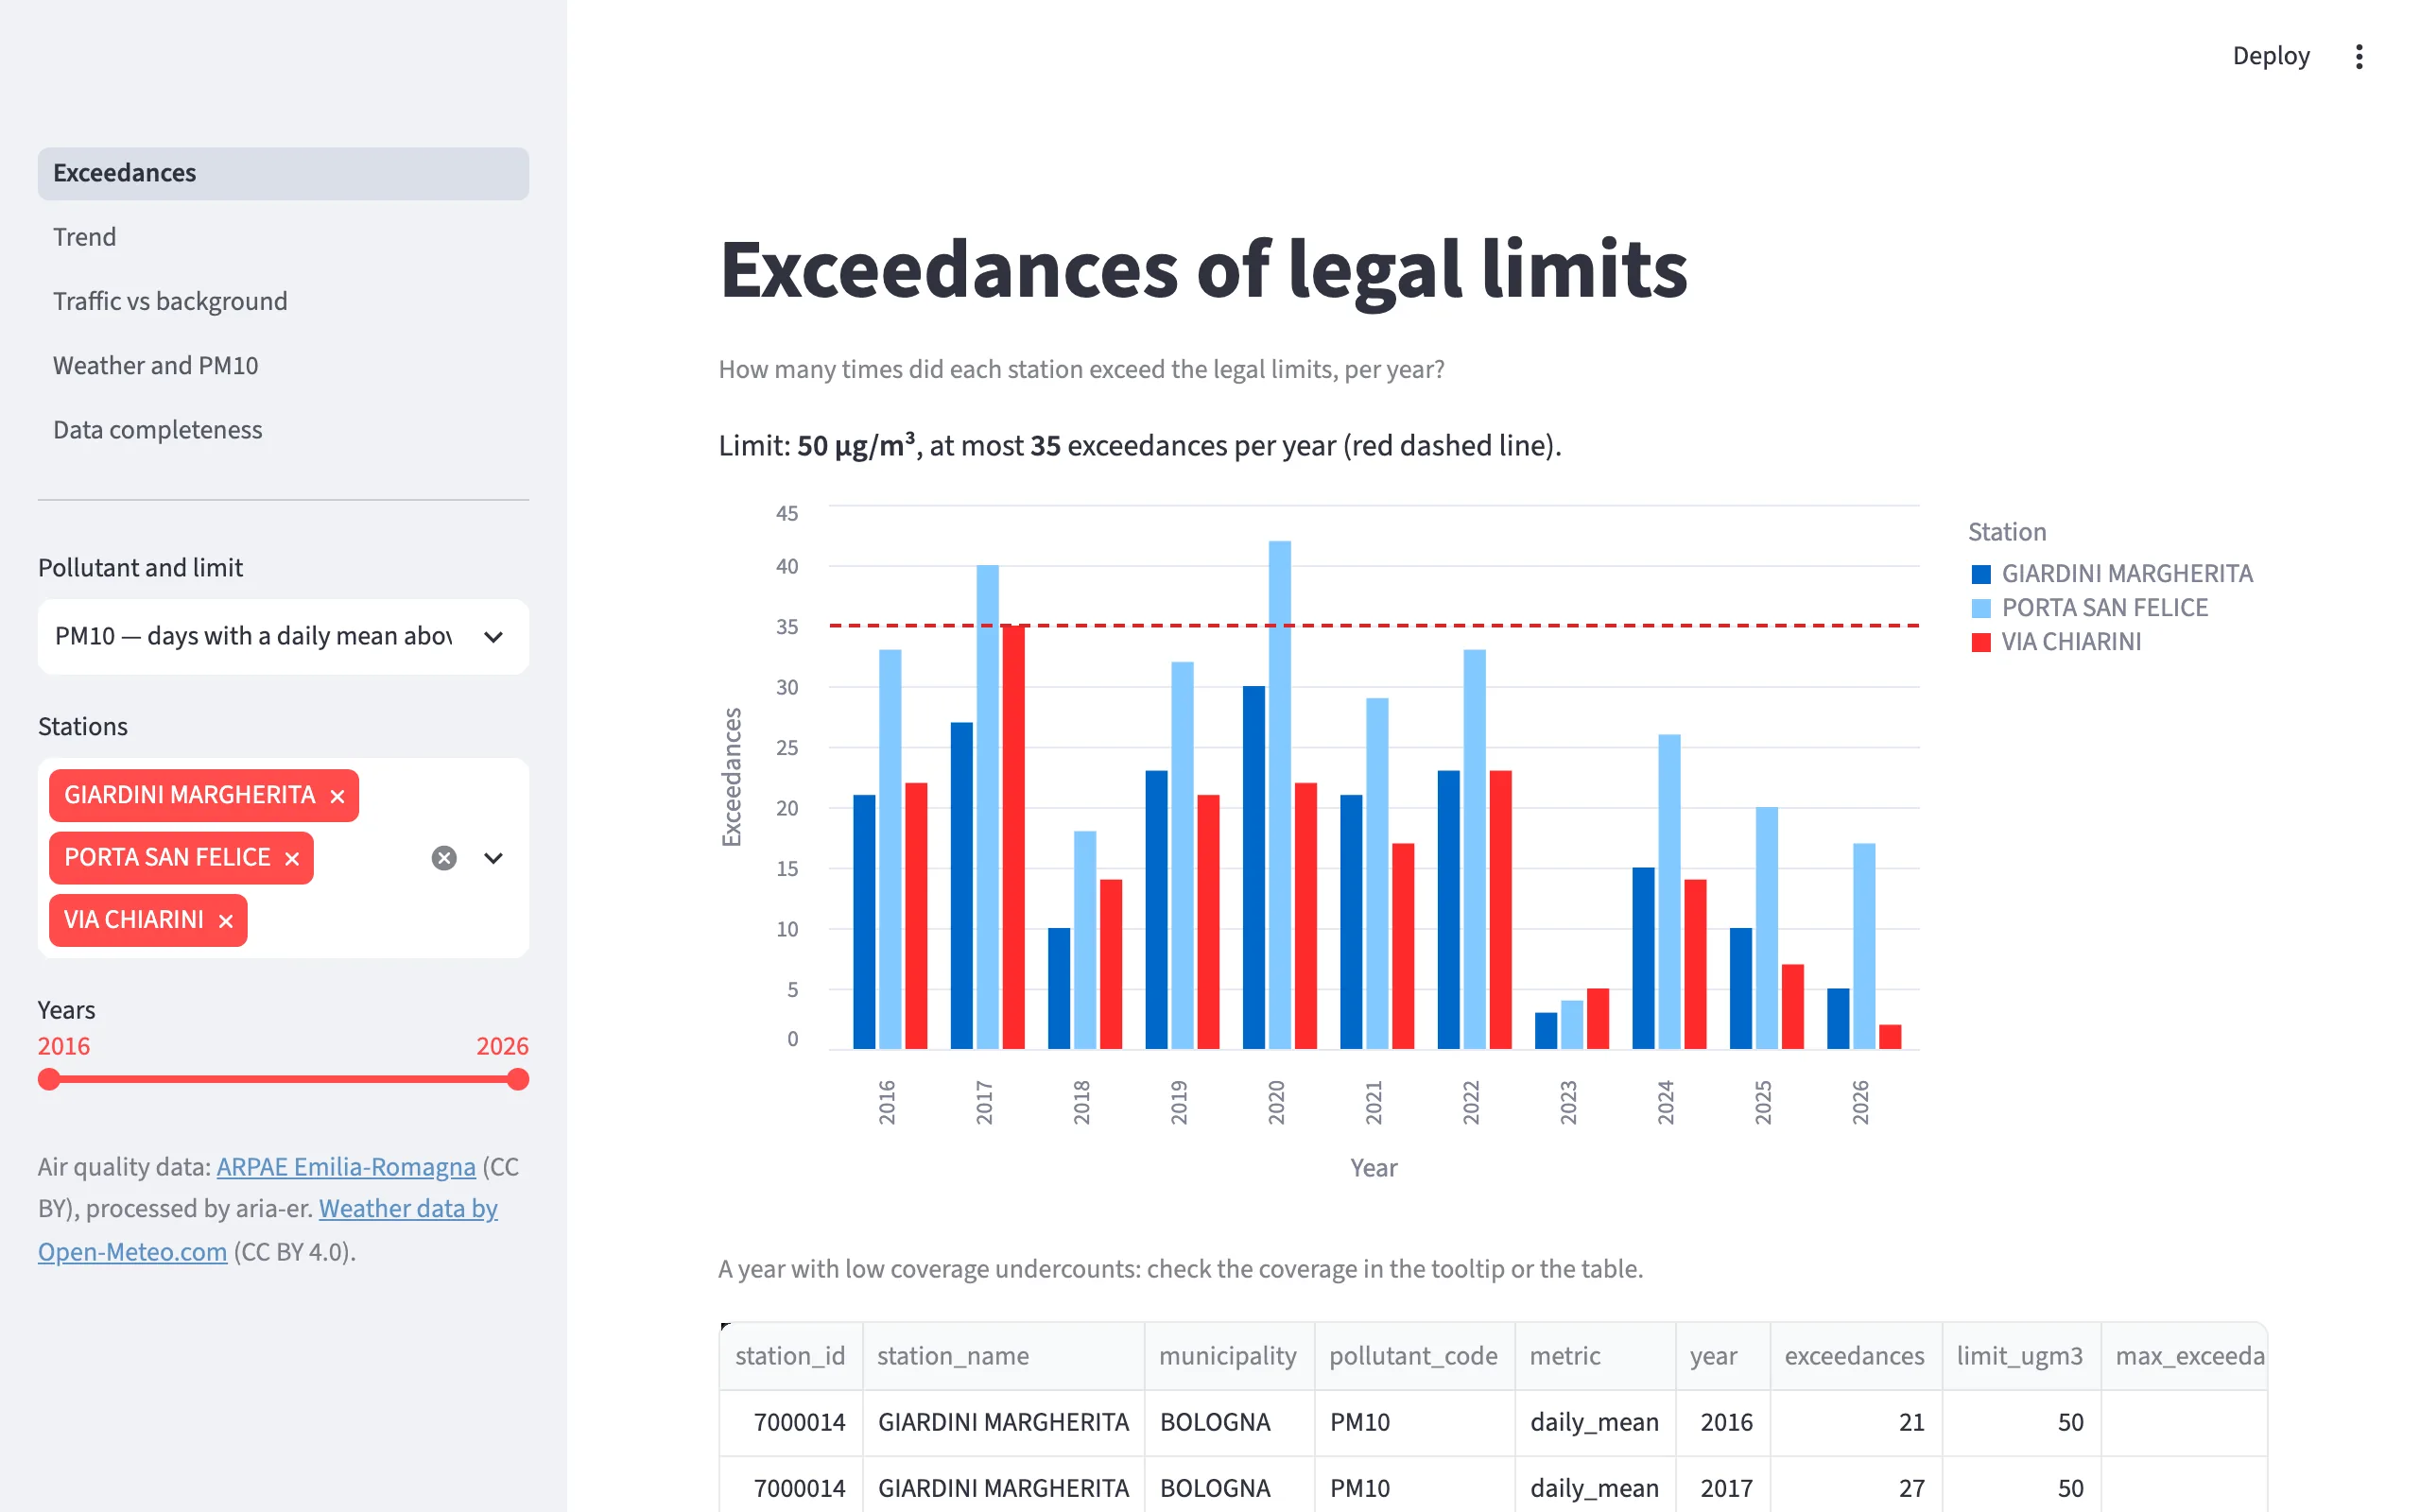
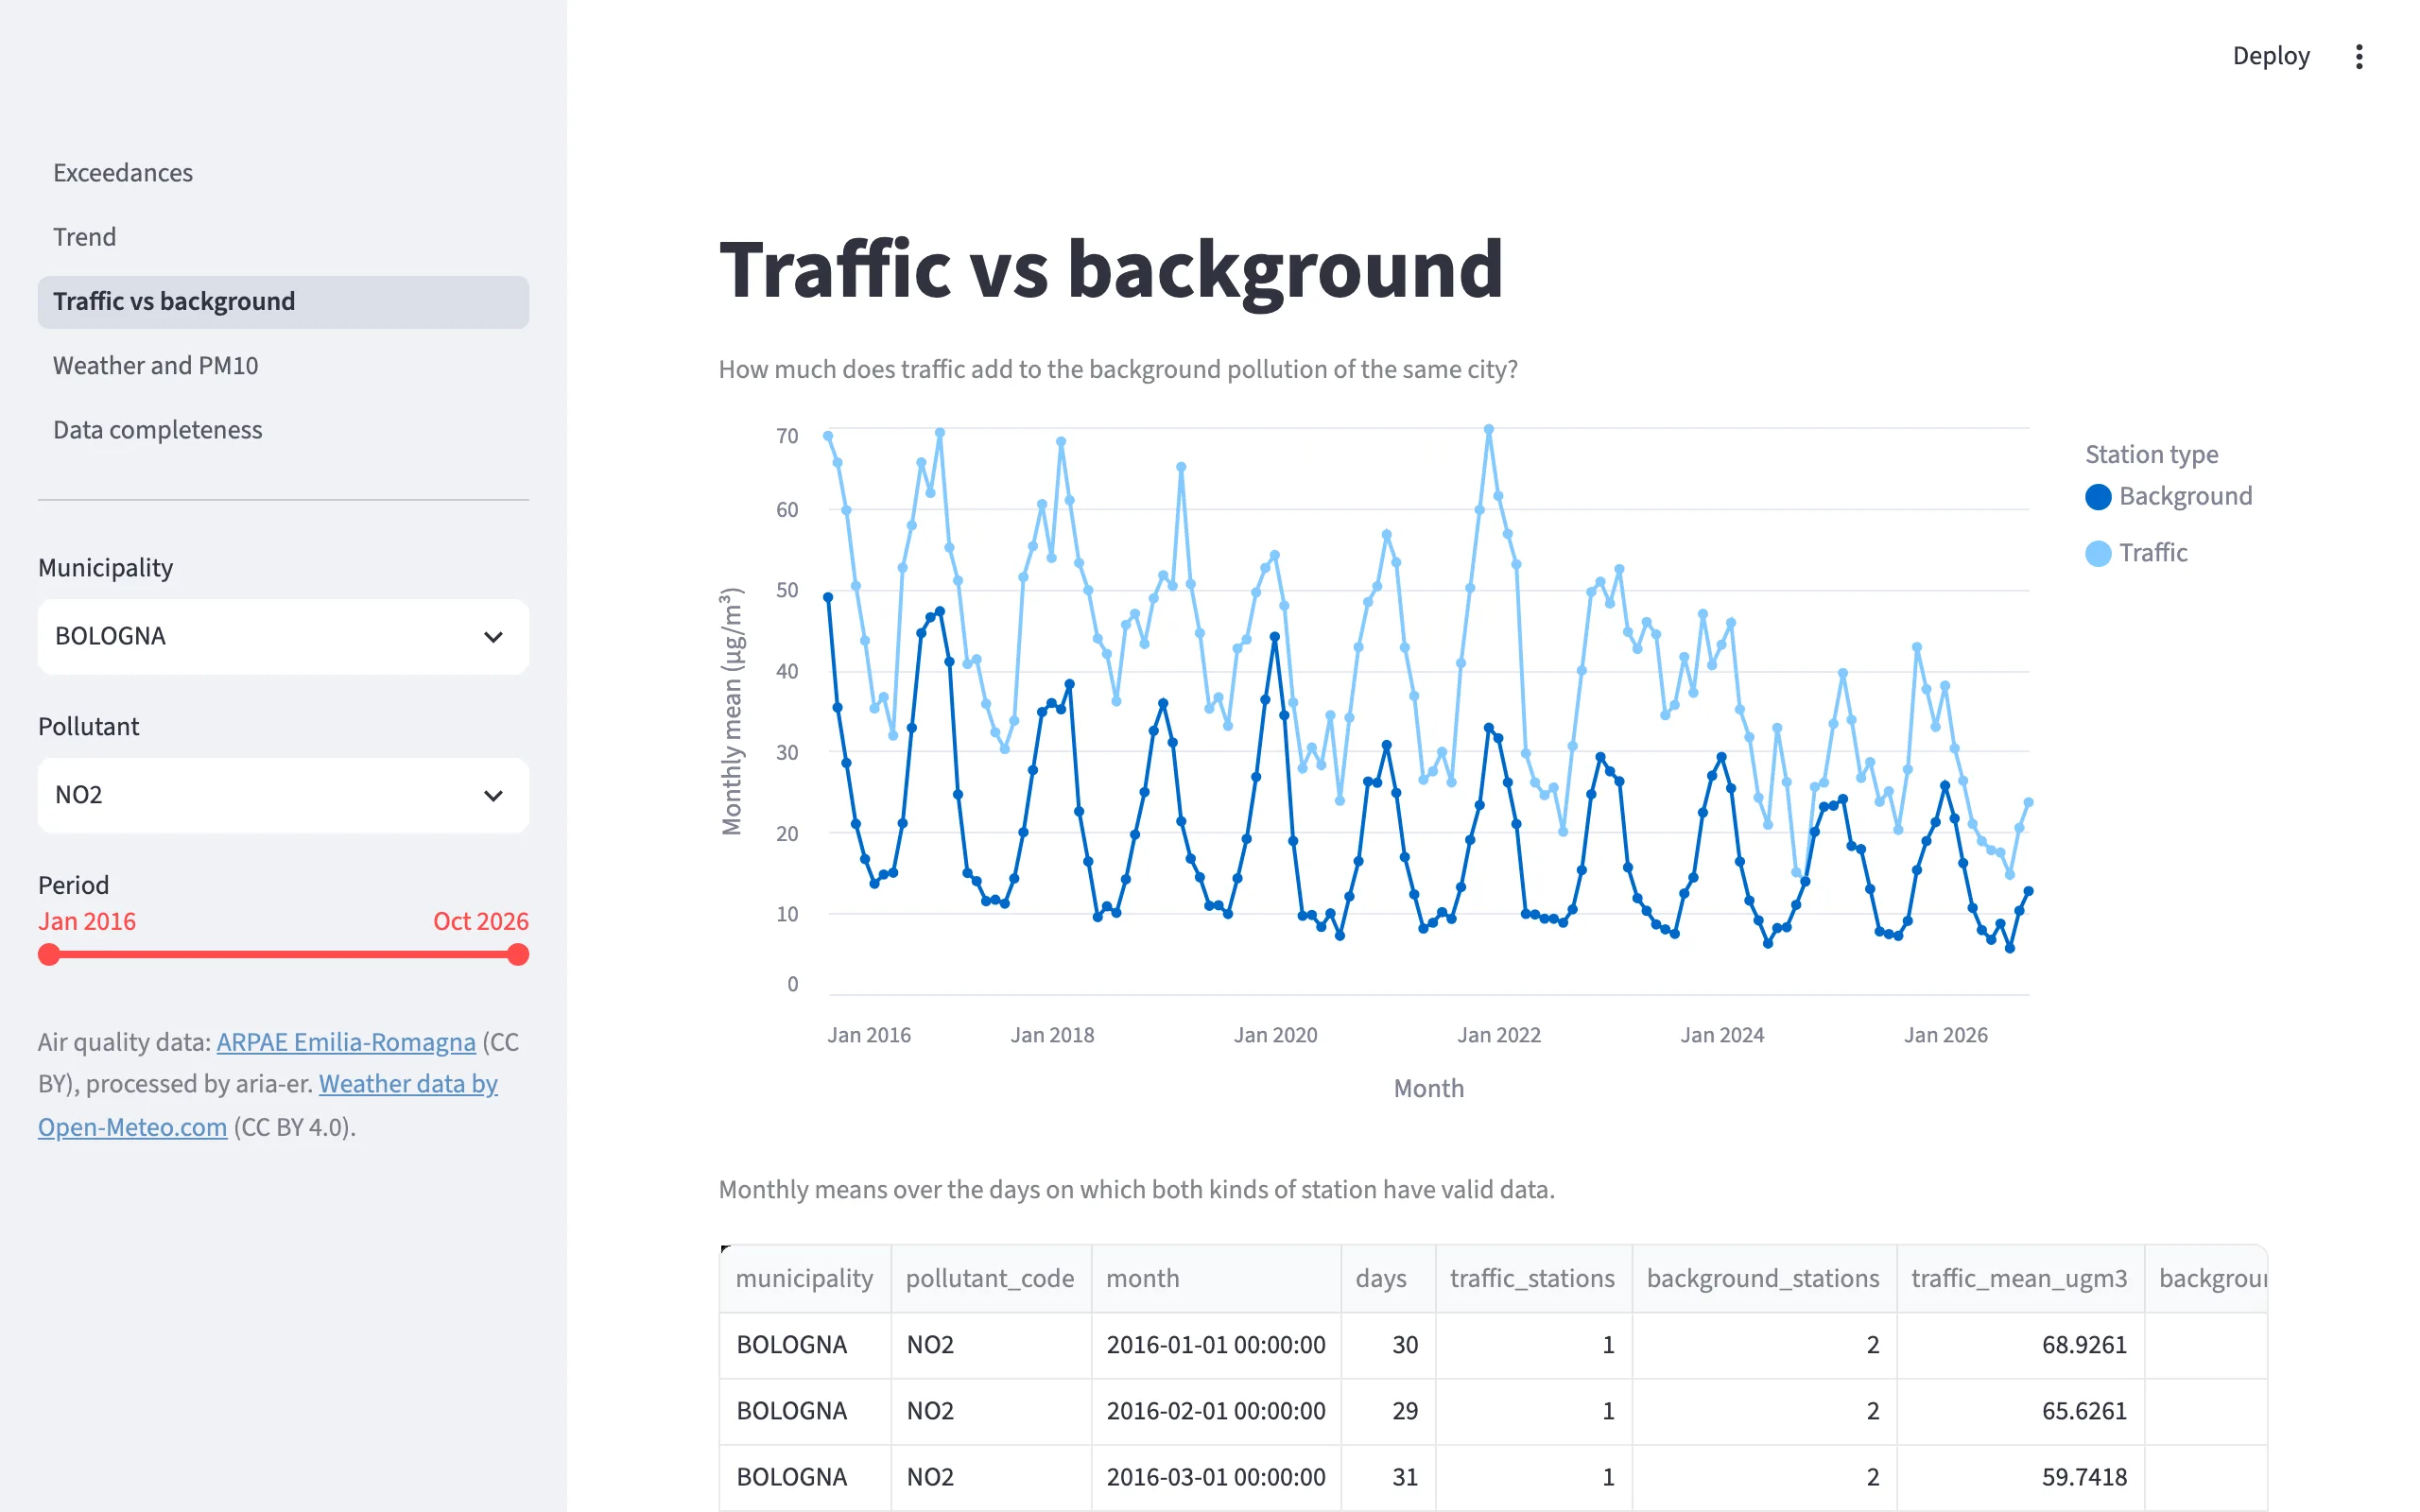
Las preguntas son sencillas: cuántas veces cada estación superó los límites legales, si el aire está mejorando, cuánto añade el tráfico a la contaminación de fondo, cómo influyen el viento y la lluvia en las PM10. Responderlas con cifras fiables es el trabajo.
Restricciones
- Los valores recientes se corrigen durante semanas: cada ejecución reprocesa una ventana de 30 días y actualiza por estación, contaminante y hora. Repetir la misma ventana produce los mismos archivos.
- Las marcas de tiempo se guardan en UTC; días y años se cuentan en UTC+1 todo el año, como hace ARPAE.
- Los límites legales están en un seed, nunca en el SQL de un modelo.
- Los valores negativos o imposibles se marcan, no se descartan.
- Los mismos modelos se ejecutan en DuckDB en un portátil y en BigQuery en la nube.
Arquitectura
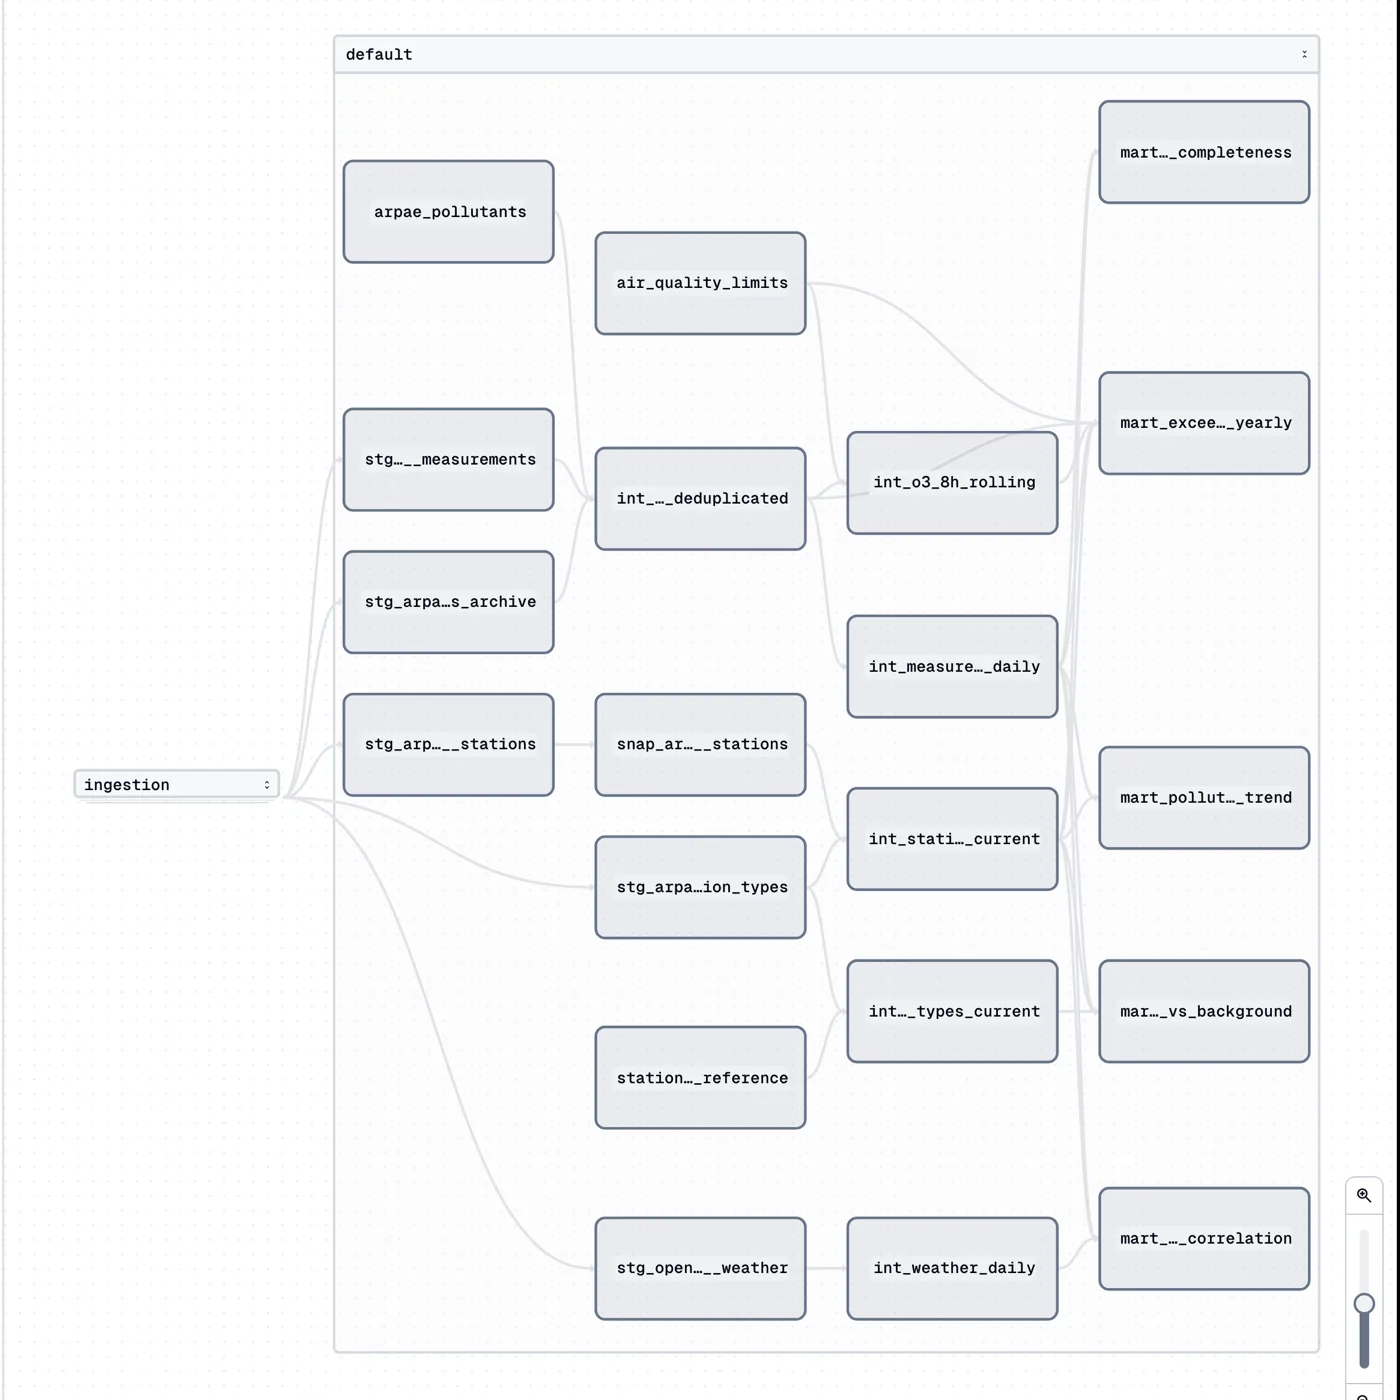
Cuatro componentes, cada uno con una tarea, unidos por archivos y tablas en lugar de llamadas: un binario en Rust escribe Parquet particionado, dbt lo convierte en marts probados, Dagster planifica y controla ambos, y un dashboard solo lee los marts. Cada fila depende solo de las de abajo.
dashboard
Streamlit: una consulta filtrada por mart, sin lógica de negocio.
orchestration
Dagster: planificación diaria, particiones mensuales, backfills, controles de frescura y completitud.
transform
dbt: staging, intermediate y marts, con más de cien tests.
aq-ingest
Workspace de Rust: clientes de ARPAE y Open-Meteo detrás de un trait de fuente, reintentos con backoff.
raw/
Parquet particionado por año y mes, cada partición reescrita de forma atómica, en disco o en Cloud Storage.
Un comando arranca todo con Docker en un portátil; el destino en la nube escribe en Cloud Storage y construye los mismos modelos en BigQuery.
Un día de datos, de principio a fin
La actualización diaria:
- 01Dagster
A la hora prevista lanza la actualización del mes en curso, una ejecución cada vez.
- 02Ingestor
Descarga los últimos 30 días del archivo de ARPAE y la meteorología de Open-Meteo, y reescribe cada mes afectado como un único archivo Parquet.
- 03dbt
Normaliza las unidades, quita duplicados, fusiona las filas nuevas y reconstruye los marts. Un test que falla detiene la ejecución.
- 04Dagster
Sus controles avisan cuando el último valor tiene más de 48 horas o cuando la completitud baja.
- 05Dashboard
Lee los marts: superaciones, tendencias, tráfico frente a fondo, meteorología, completitud.
Decisiones y compromisos
- 01
Reescribir una partición, nunca añadir
Cada mes es un archivo Parquet, reescrito entero con las filas fusionadas y sustituido de forma atómica. Repetir una ventana da los mismos bytes; el precio es reescribir un mes para cambiar una hora, poco a este tamaño.
- 02
Las reglas legales, no una media cualquiera
Un día cuenta solo con 18 horas válidas, el valor se redondea antes de compararlo con el límite, el día va en UTC+1. Sin cualquiera de ellas, los recuentos no coincidían con los de ARPAE.
- 03
Marcar, no descartar
Los valores negativos, nulos o inverosímiles se quedan en los datos con una marca y fuera de los agregados. Dos tests de aviso los mantienen visibles en lugar de hacerlos desaparecer en silencio.
- 04
Un solo conjunto de modelos, dos almacenes
El SQL que cambia entre DuckDB y BigQuery está en unas pocas macros. Un emulador comprueba la versión de BigQuery en cada pull request, y la ejecución en un proyecto real de Google Cloud dio marts idénticos.
- 05
Sin streaming
Las fuentes publican horas después de medir y corrigen durante meses, y cada pregunta es diaria o más amplia. Basta un lote diario; el streaming solo añadiría piezas móviles.
Verificado con ARPAE
Cada recuento de superaciones se comparó con lo que publica ARPAE. Dos comprobaciones cambiaron el código: las PM10 coincidieron solo al redondear el valor diario antes de compararlo, y el ozono coincidía en 29 estaciones de 43 hasta que las ventanas de 8 horas se calcularon sobre cada hora, también las que faltan.
| Indicador | ARPAE | aria-er |
|---|---|---|
| Días de PM10 por encima de 50 µg/m³, Porta San Felice, 2025mart_exceedances_yearly | 20 | 20 |
| Días de ozono por encima de 120 µg/m³, Via Chiarini, 2025mart_exceedances_yearly | 54 | 54 |
| Estaciones con los mismos días de superación de PM10 en 2026mart_exceedances_yearly | 64 | 64 |
| Estaciones con los mismos días de superación de ozono en 2026mart_exceedances_yearly | 43 | 43 |
Resultados en directo
Los gráficos de abajo leen la exportación que aria-er publica cada mañana en GitHub Pages: los mismos marts del dashboard, actualizados por el propio pipeline.
Cargando los últimos datos…
Dashboard y pipeline
Lo que viene
- Una exportación diaria de los marts publicada por el pipeline, para mostrar resultados al día en esta página.
- Superaciones de ozono como media de tres años, como pide la ley, cuando haya tres años completos cargados.
- Cargar el archivo en una tabla nativa de BigQuery, si llegara a superar la cuota gratuita de lecturas.
Código
El repositorio es público, con licencia MIT. Un solo comando arranca todo con Docker y carga diez años de datos.